
Agent Safehouse agent-safehouse.dev
Leaderboard arena.ai/leaderboa…
そして同時に強化学習の限界もわかった
LLMは強化学習のパワーのおかげで人間より賢くなれたんやなあ
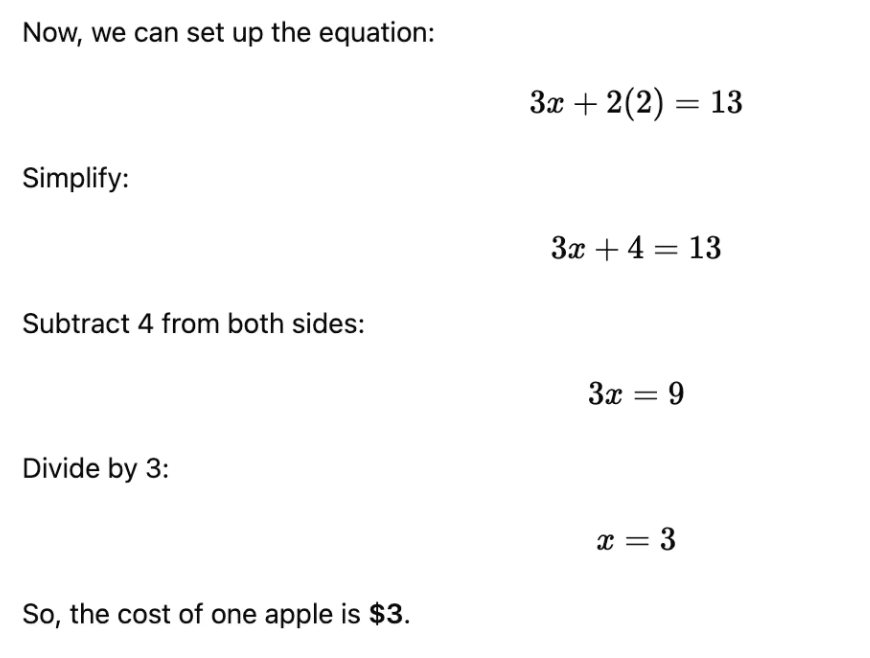
LLMがこのように、ずばり答を言うのではなく過程から回答するのは、トークンに渡って推論を分散するためであって、ユーザーが読み易くするためとかではない。訓練時にそういうフォーマットで回答するように学習している。
Agent Safehouse agent-safehouse.dev
Leaderboard arena.ai/leaderboa…
そして同時に強化学習の限界もわかった
LLMは強化学習のパワーのおかげで人間より賢くなれたんやなあ
LLMがこのように、ずばり答を言うのではなく過程から回答するのは、トークンに渡って推論を分散するためであって、ユーザーが読み易くするためとかではない。訓練時にそういうフォーマットで回答するように学習している。