
Leaderboard arena.ai/leaderboa…
そして同時に強化学習の限界もわかった
LLMは強化学習のパワーのおかげで人間より賢くなれたんやなあ
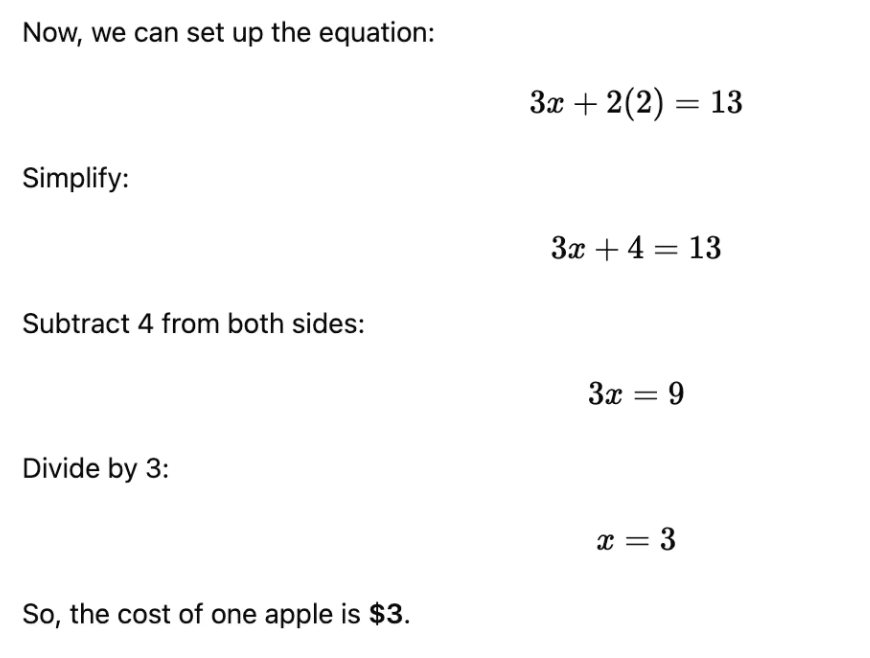
LLMがこのように、ずばり答を言うのではなく過程から回答するのは、トークンに渡って推論を分散するためであって、ユーザーが読み易くするためとかではない。訓練時にそういうフォーマットで回答するように学習している。
[2203.02155] Training language models to follow instructions with human feedback arxiv.org/abs/2203….
これ見てる。評判通りわかりやすいなあ。なるほど、ポストトレーニング時しか出現しない専用のトークンがあるから、「本文」と「地の文」を確実に区別できるのね。
Influencing LLM Output using logprobs and Token Distribution blog.sicuranext.com/influenci…